第五章:循环
目录 (21)
- 核心内容 Part I
- 5.1 重复执行相同的步骤:for 循环
- 5.2 按整数序列重复:range()
- 5.3 循环中逐步累加与计数
- 5.4 条件成立时继续执行:while 循环
- 5.5 改变循环流程:break 与 continue
- 5.6 在函数中组织循环
- 核心内容 Part I 练习
- 核心内容 Part II
- 5.7 先把多条数据放在一起:列表的三个基本操作
- 5.8 用循环逐条处理列表中的数据
- 5.9 对每个对象再重复:嵌套循环
- 5.10 同时取得编号和数据:enumerate()
- 5.11 循环未被 break 中断时:else 子句
- 5.12 持续接收输入:哨兵值与交互式循环
- 核心内容 Part II 练习
- 本章回顾
- 补充说明(Tips)
- 提示 1:不要在 for 循环体内修改循环变量
- 提示 2:浮点数精度误差与财务金额口径
- 提示 3:何时手写累加循环,何时直接调用 sum()?
章节导航:上一章:第四章 if 语句与分支结构
在高校教务管理与日常商业数据分析中,我们经常遇到两类重复性的计算任务:
第一类是同一操作的批量执行。例如,西南财经大学(SWUFE)要向全校两万多名学生发送秋季运动会开幕通知。发送规则完全相同:依次读取每位学生的姓名与学号,填入固定模板并发送。给第二位学生发通知并不依赖第一位学生的计算结果,本质上是将同一套独立操作重复执行两万多次。
第二类是数值的逐步累加与汇总。例如,教务系统根据成绩单计算学生的学期平均学分绩点(GPA)。成绩单包含若干门课程,每门课均有对应的学分与绩点:
计算时,每读入一门课需完成两笔累加:将 “课程学分$ \times $课程绩点” 累加至分子(总学分绩点),并将 “课程学分” 累加至分母(总学分)。计算第二门课时,必须在第一门课的累计值上继续累加;后续课程依此类推。每一步算出的中间结果,都是下一步计算的基础。
面对这两类任务,仅靠前面学过的顺序结构会遇到两个明显的困难:
- 代码随数据规模膨胀:顺序结构中每执行一次操作就需编写一行代码。若向两万名学生逐一发送通知,就需编写两万行代码;一旦通知内容调整,所有代码都要逐行修改,既繁琐又极易疏漏。
- 固定行数的代码无法适应动态数据量:每位学生每学期选修的课程门数并不固定(如 5 门或 8 门)。顺序结构要求在编写代码时就固定运算步数,无法用一段固定行数的算式直接处理长度不一的成绩单。
解决此类问题的核心工具是循环结构(Loop)。其核心思路在于将变动的数据与固定的处理逻辑解耦:我们只需编写单次处理的通用规则,交由计算机按指定条件自动重复执行。
- 批量任务(如群发通知):编写单名学生的通知发送代码,让计算机沿名单依次执行。即便学生多达数万人,核心代码也仅需两三行;
- 动态累加(如计算 GPA):编写单门课程的累加规则,每读入一门课便更新一次合计值。无论成绩单包含多少门课,同一段代码均能自动完成核算。
Python 提供了两种循环语句来控制重复过程:
for循环:适合处理遍历范围已知、数量确定的数据,例如顺着名单逐个发送通知,或沿成绩单逐门核算学分;while循环:适合处理重复次数未知、只需“满足特定条件便继续”的场景,例如在累计学分未达到毕业要求时持续选课,直至学分达标为止。
上一章的分支结构决定了程序“走哪条路”,本章的循环结构则决定了程序“重复多少次”。将二者结合,便能顺畅表达绝大多数业务逻辑与算法流程。
核心内容 Part I
5.1 重复执行相同的步骤:for 循环
5.1.1 从重复书写到重复执行
先看发通知的简化场景。若需依次向第 1 至第 3 位学生发送运动会通知,使用顺序结构需连写三行 print() 语句:
print("向第 1 位学生发送运动会通知")
print("向第 2 位学生发送运动会通知")
print("向第 3 位学生发送运动会通知")
输出:
向第 1 位学生发送运动会通知
向第 2 位学生发送运动会通知
向第 3 位学生发送运动会通知
观察上述代码可以发现,打印的文字模板完全一致,唯一变化的仅是其中的学生编号(1、2、3)。
既然操作固定而仅编号变动,我们便可将变动的数据与固定的操作拆开:用变量 student_id 依次取 1、2、3,每取出一个编号,便自动执行一次打印:
# 对 1 到 4(不含 4)之间的每一个学生编号 student_id:
#     向学生 student_id 发送运动会通知
# 全部发完后,打印结束提示
for student_id in range(1, 4):
    print(f"向第 {student_id} 位学生发送运动会通知")

print("通知发送完毕")
输出:
向第 1 位学生发送运动会通知
向第 2 位学生发送运动会通知
向第 3 位学生发送运动会通知
通知发送完毕
代码中的 range(1, 4) 生成了一个从 1 开始、到 4 之前结束的连续整数序列,即 1、2、3。该范围遵循“包含起点、不包含终点”的规则,因此终点 4 不在序列中(5.2 节将详细讨论起止边界与步长)。
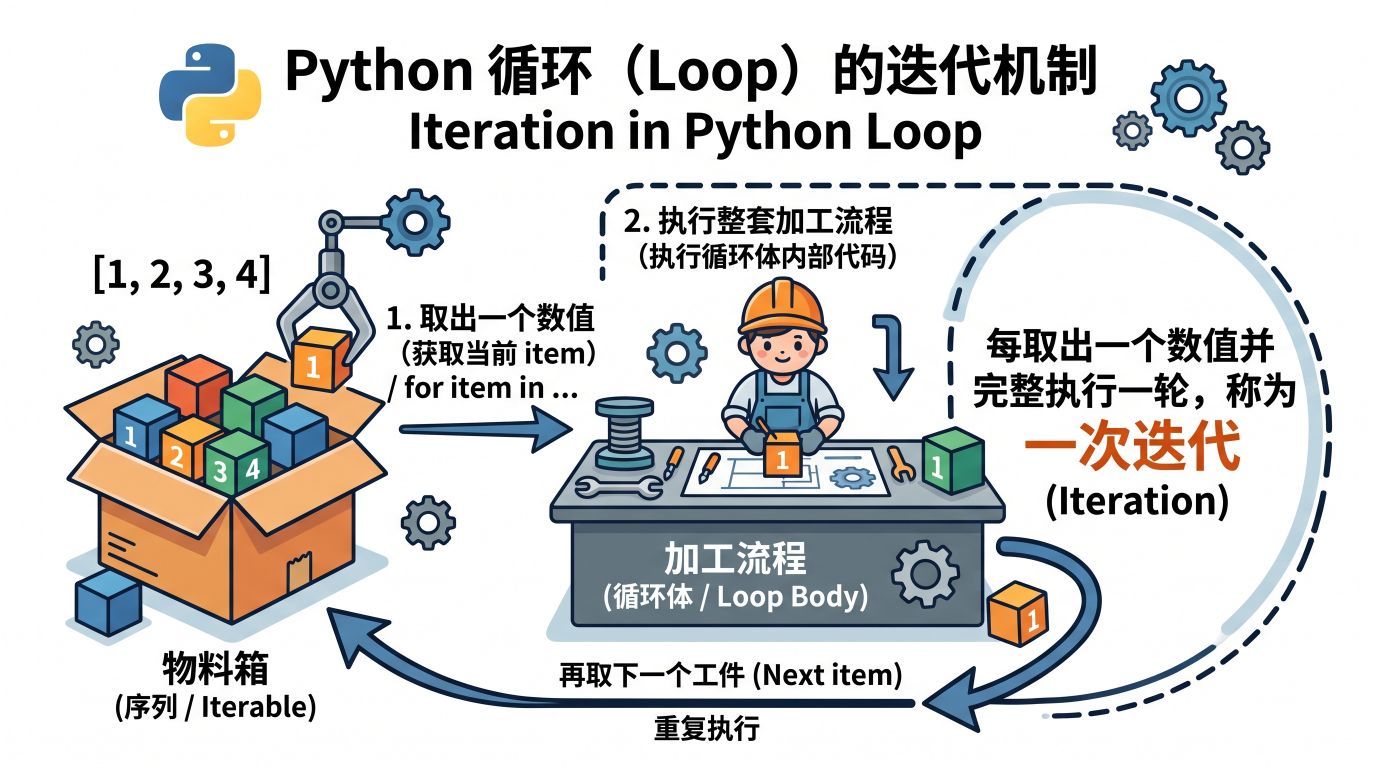
语句 for student_id in range(1, 4): 的执行过程犹如工厂流水线上的逐件加工:
- 解释器从
range(1, 4)序列中按顺序取出一个整数,赋给循环变量student_id; - 执行下方缩进的代码块(循环体);
- 一轮执行完毕后,解释器自动取出下一个数,无需手动递增变量,直接进入下一轮。
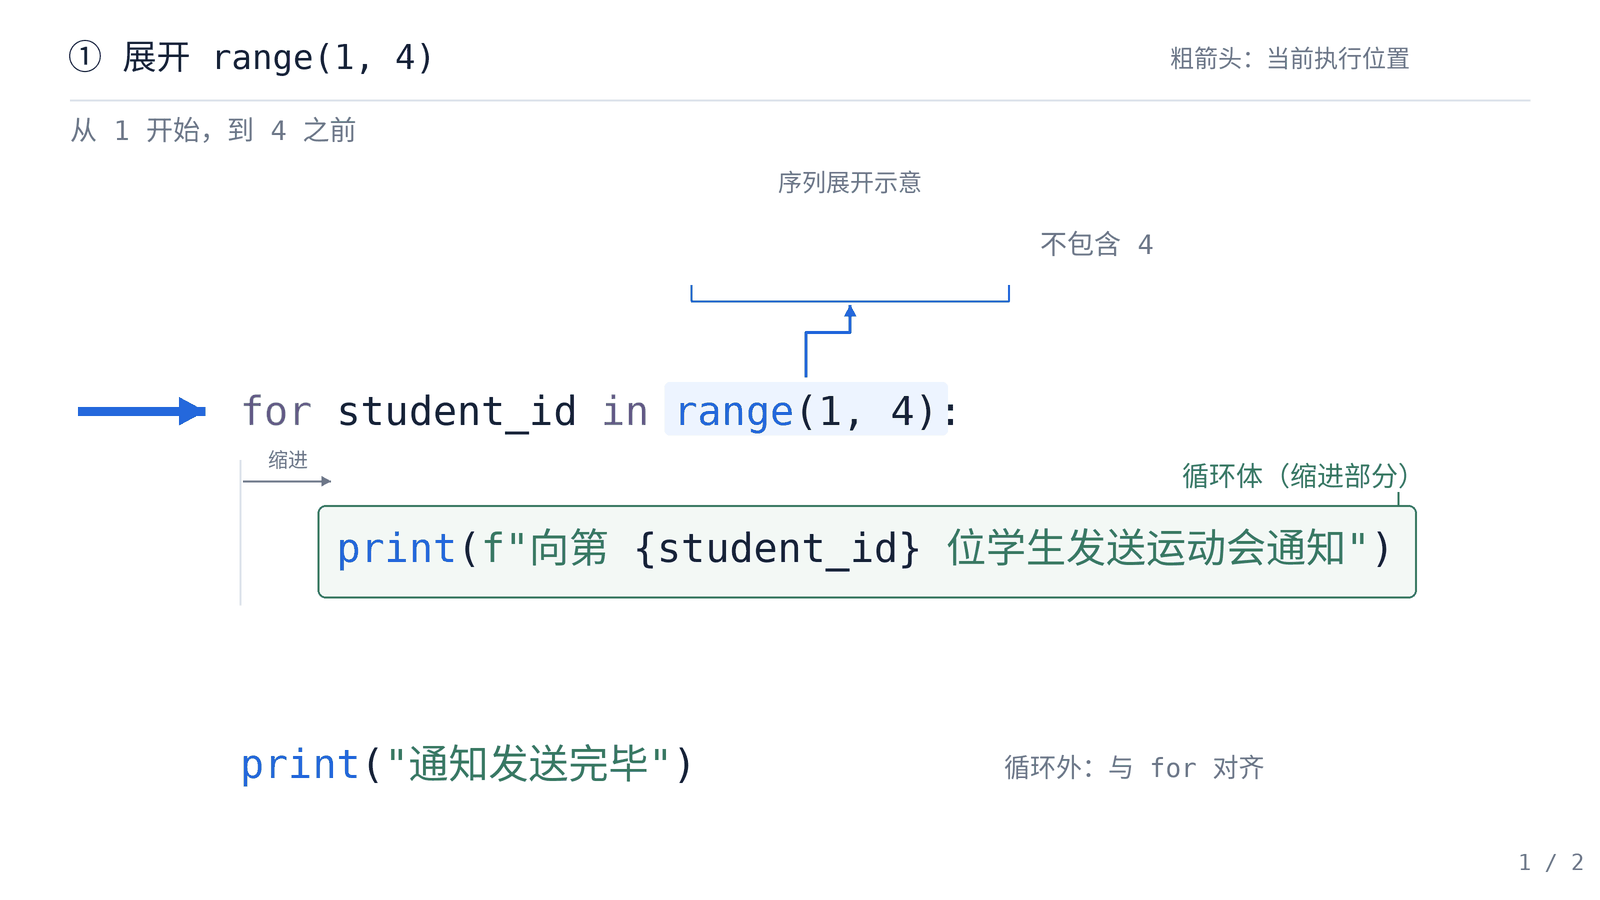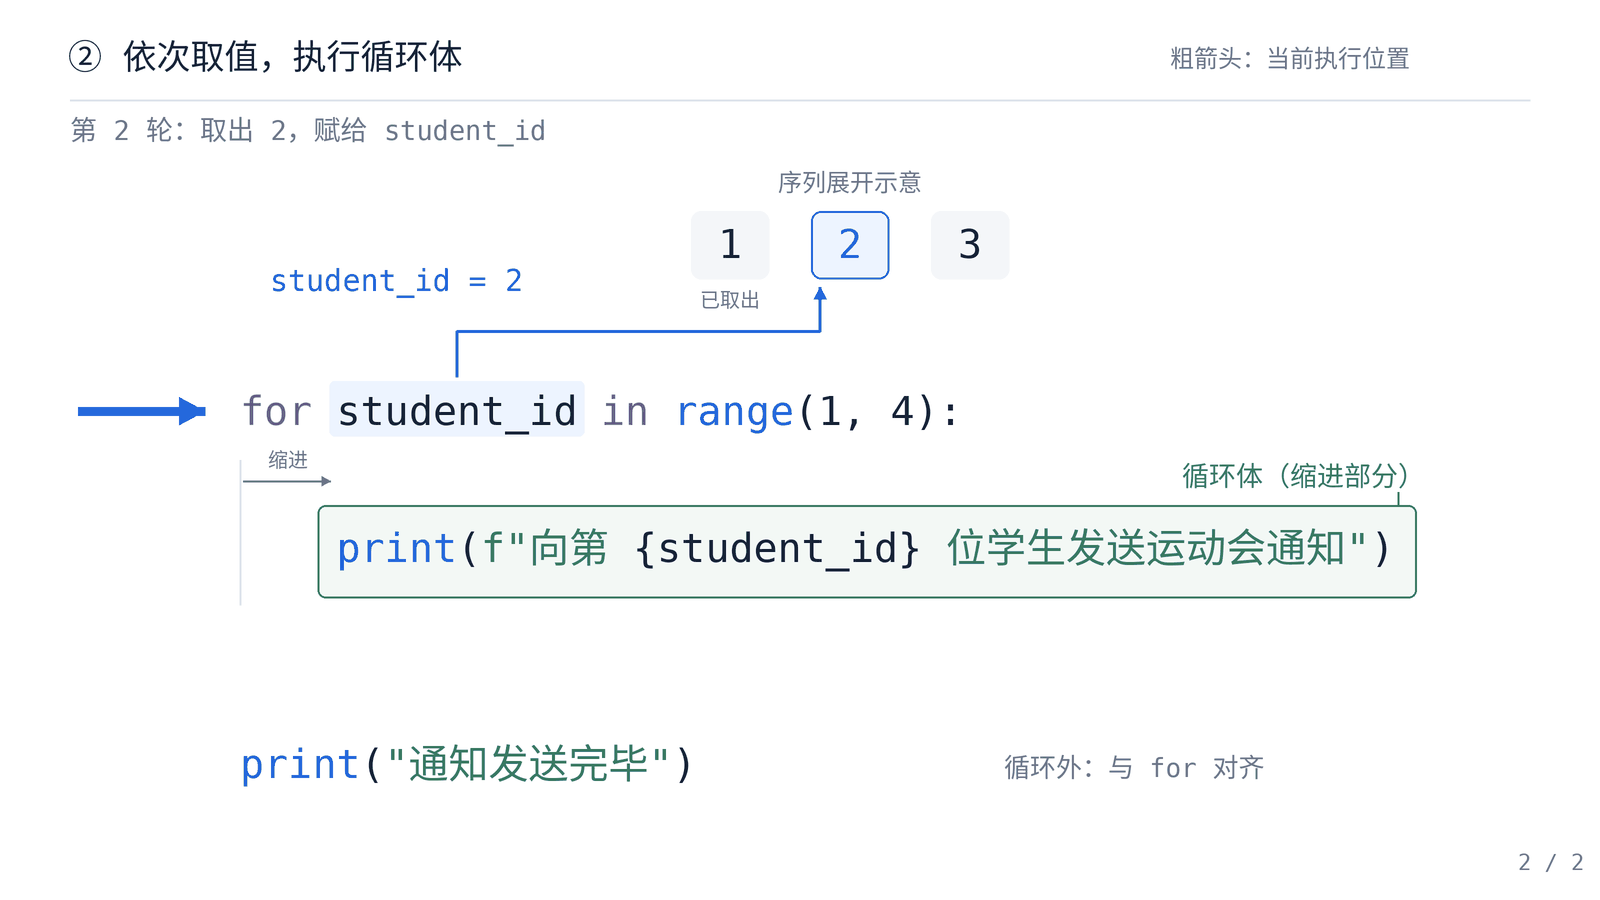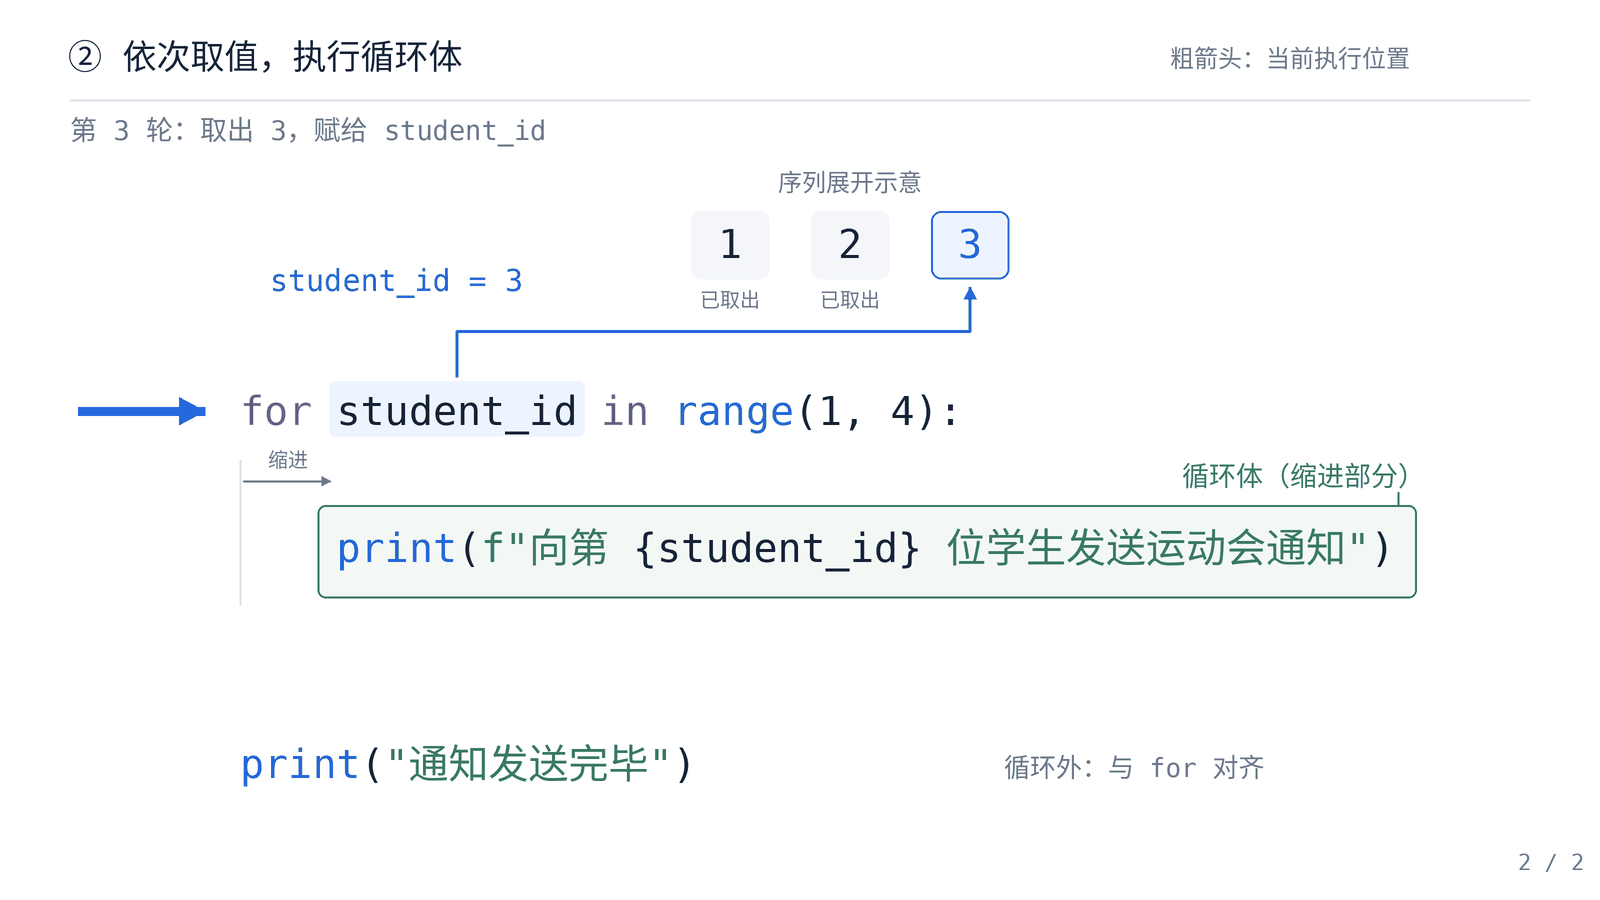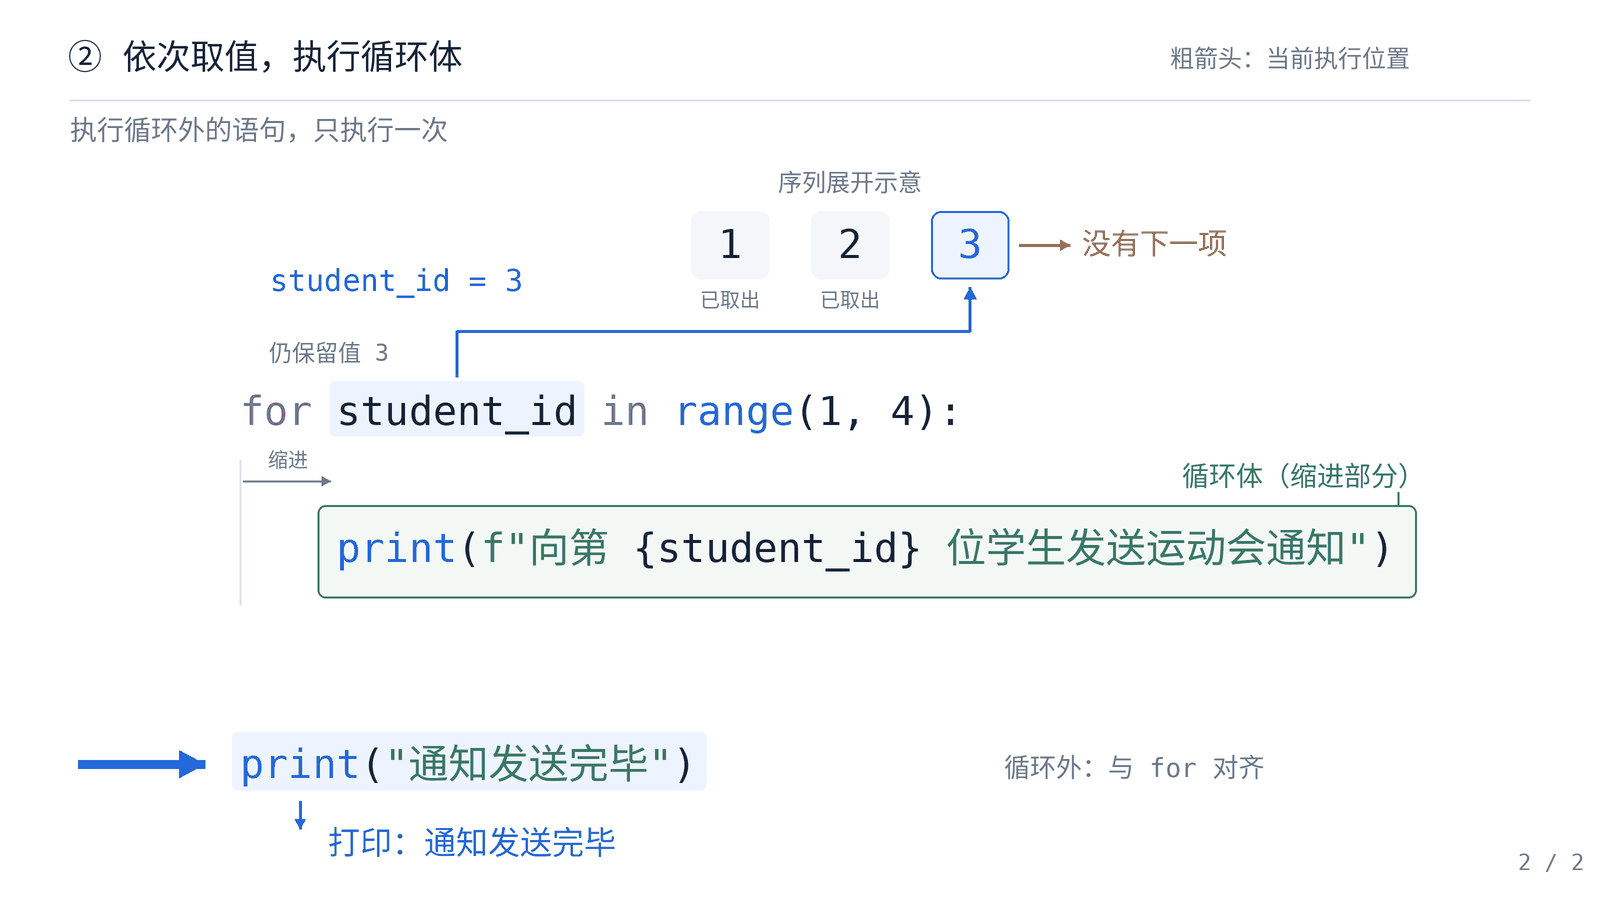
从取出一个数据到将缩进代码块完整执行一遍的过程,在编程中称为一次迭代(Iteration)。本例序列包含 3 个整数,循环便依次完成 3 次迭代。当序列中的数字全部取出后,循环自动结束,程序回到主流程,继续执行未缩进的语句 print("通知发送完毕")。若将 range(1, 4) 改为 range(7, 10),student_id 便会依次取 7、8、9。
提示(循环变量的命名):
student_id是用户自定义的变量名,并非 Python 的内置关键字。若将其改为其他合法名称,循环内部引用的变量名也需同步调整。编写代码时,建议选用具有明确业务含义的名称(如student_id、month、price),以便于后续阅读与维护。
5.1.2 for 循环的基本结构
结合上述示例,使用 range() 的 for 循环语法结构可归纳为:
for 循环变量 in range(起点, 终点):
    循环体语句 1
    循环体语句 2
    ...

循环结束后继续执行的语句
其中,range() 负责提供有序的连续整数序列,循环变量则在每轮迭代开始时接收当前取出的数字。
在语法规则上,for 与 in 为固定搭配的关键字,行末的英文冒号 : 标志着下方循环体的开始。**循环体(Loop Body)**是每轮迭代均需重复执行的一组语句,按规范统一向右缩进 4 个空格。
当某行代码取消缩进、重新与 for 左对齐时,表明该语句已脱离循环体,属于整个循环执行完毕后才运行的后续代码。
随堂练习:先后将代码中的 range(1, 4) 改为 range(1, 5) 和 range(7, 10)。先在纸上写出预计输出的学生编号与总行数,再运行程序验证判断。
5.2 按整数序列重复:range()
5.2.1 从起点取到终点及左闭右开原则
上一节用 range(1, 4) 依次取出了 1、2、3。若要打印从 1 到 5 的整数,只需将终点参数设为比 5 大 1 的数,即 6:
for number in range(1, 6):
    print(number)
输出:
1
2
3
4
5
range(1, 6) 表示从 1 开始、到 6 之前停止的整数序列。其核心规则为:包含起点,不包含终点(对应数学中左闭右开区间 [\text{start}, \text{stop}) 内的整数)。
Python 采用“含头不含尾”的设计,主要基于两点优势:
- 元素数量直观可求:序列长度等于“终点减去起点”(\text{stop} - \text{start})。例如
range(1, 6)包含 6 - 1 = 5 个数;遍历全年 12 个月写作range(1, 13),恰好为 13 - 1 = 12 个月;若从1遍历至正整数 n,终点设为 n + 1,元素个数恰为 (n + 1) - 1 = n 个; - 相邻区间拼接时不重不漏:例如将数据拆分为
range(1, 5)与range(5, 9)两批处理,前一批取至4,后一批始于5,分界点5既不重复也不遗漏。
因此,在步长为 1 的情况下,若希望循环包含整数 n,终点参数直接设为 n + 1 即可。
思考与实践:编写一个函数
print_triangle(n),接收正整数参数n,打印出由 n 行星号组成的直角三角形。例如当 n = 4 时,输出如下:
text* ** *** ****思路解析:观察图形可知,第 1 行有 1 个星号,第 2 行有 2 个星号……第 i 行恰有 i 个星号。因此,行号变量 i 需依次取 1, 2, \dots, n。根据“含头不含尾”的规则,循环范围应写作
range(1, n + 1),以保证第 n 行完整输出:pythondef print_triangle(n): for i in range(1, n + 1): print("*" * i) # 函数调用 print_triangle(4)
5.2.2 起点、终点与步长
除指定起点与终点外,range() 共支持三种调用形式:
| 语法形式 | 规则说明 | 示例 | 依次生成的整数序列 |
|---|---|---|---|
range(stop) |
仅指定终点:默认从 0 开始,每次加 1 |
range(4) |
0, 1, 2, 3 |
range(start, stop) |
指定起点与终点:默认每次加 1,不含终点 |
range(1, 4) |
1, 2, 3 |
range(start, stop, step) |
同时指定起点、终点与步长,不含终点 | range(1, 7, 2) |
1, 3, 5 |
当仅传入一个参数 range(stop) 时,序列默认从 0 起步,生成的整数个数恰好等于 stop。
在三个参数的形式中,第三个参数为步长(Step),代表相邻数值间的增量。步长为正时数值递增,步长为负时数值递减。例如,利用负步长实现运动会开幕倒计时:
for remaining_days in range(3, 0, -1):
    print(f"距开幕还有 {remaining_days} 天")
输出:
距开幕还有 3 天
距开幕还有 2 天
距开幕还有 1 天
该序列从 3 出发,每次递减 1,在到达终点 0 之前停止,因而依次取出 3、2、1。
提示(range 的参数限制):
range()的参数必须均为整数。传入浮点数(如range(1, 4, 0.5))会引发TypeError;若将步长设为0(无法推进序列),则会引发ValueError。
5.2.3 边界与空序列
循环体是否执行,取决于 range() 能否生成有效数值。若步长方向与终点相对位置相悖,range() 将生成不包含任何元素的空序列:
| 表达式 | 生成的整数 | 循环体执行次数 | 原因分析 |
|---|---|---|---|
range(1, 4) |
1, 2, 3 |
3 | 起点小于终点,每次加 1 向终点靠拢 |
range(4) |
0, 1, 2, 3 |
4 | 默认从 0 开始,每次加 1,共生成 4 个整数 |
range(3, 0, -1) |
3, 2, 1 |
3 | 起点大于终点,每次减 1 向终点靠拢 |
range(3, 3) |
(无) | 0 | 起点等于终点,不含终点,无法取出任何数 |
range(3, 0) |
(无) | 0 | 默认步长为 +1,从 3 递增无法到达 0 |
简而言之:步长为正时,生成的数值必须严格小于终点 stop;步长为负时,生成的数值必须严格大于终点 stop。若起点本身即不满足该约束,range() 将不生成任何元素。遇到空序列时,Python 不会报错,而是直接跳过循环体,继续执行后续代码。
随堂练习:分别使用 range() 打印上半年第 1 至第 6 月的连续月份编号,以及第 2、4、6 月三个偶数月份编号。先在纸上写出 range() 参数,再运行代码检验末尾月份是否遗漏。
5.3 循环中逐步累加与计数
5.3.1 从 1 加到 N:累加器
计算 1 到 5 的整数之和尚可手动书写 1 + 2 + 3 + 4 + 5,但面对 1 到 100 乃至成千上万笔订单总额时,手动列式显然不再适用。
在 for 循环中,循环变量每轮都会被新取出的值覆盖。若要将各轮数值汇总,就必须在循环开始前,在外部准备一个专门记录阶段性合计的变量。这一用于保存中间累计结果的变量,称为累加器(Accumulator)。
n = 5
total = 0  # 累加器初始化:累加开始前,账面合计为 0

# 对 1 到 n 之间的每一个数 number(按顺序):
#     把 number 加到 total 上
for number in range(1, n + 1):
    total = total + number

# 循环体结束,继续执行后续主流程代码
print(f"从 1 到 {n} 的整数之和:{total}")
输出:
从 1 到 5 的整数之和:15
为使边界值 n 计入累加,range() 的终点参数设为 n + 1。
核心语句 total = total + number 体现了赋值运算的执行顺序:先计算等号右侧表达式,再将结果存入等号左侧变量。解释器先读取 total 的当前值,加上本轮取出的 number,再将新合计值写回 total 覆盖旧值。这与会计记账中“期初结余 + 本期发生额 = 期末结余”的流水账机制完全一致:
| 阶段 | 本轮取出的 number |
累加前的 total |
算式与赋值过程 | 累加后的 total |
|---|---|---|---|---|
| 初始化 | — | — | 初始账面赋值为零 | 0 |
| 第 1 次迭代 | 1 | 0 | 0 + 1 |
1 |
| 第 2 次迭代 | 2 | 1 | 1 + 2 |
3 |
| 第 3 次迭代 | 3 | 3 | 3 + 3 |
6 |
| 第 4 次迭代 | 4 | 6 | 6 + 4 |
10 |
| 第 5 次迭代 | 5 | 10 | 10 + 5 |
15 |
每轮迭代完成时,total 保存的都是从 1 加至当前 number 的阶段性合计;第 5 轮结束后,total 中保存的即为最终总和 15。
提示(复合赋值简写):Python 中,
total = total + number可简写为复合赋值形式total += number;同理,变量自增 1 可简写为count += 1。
5.3.2 初始化与输出应该放在哪里
使用累加器时,初学者易犯的错误是将初始化语句写在循环体内部。若每轮迭代均执行 total = 0,就相当于每记一笔账前都先将账本清零:
# 错误示范:在循环体内把累加器反复清零,导致前面的累加结果全部丢失
n = 5

for number in range(1, n + 1):
    total = 0  # 每一轮进入循环体,total 都先被设置为 0
    total = total + number

print(f"错误的合计:{total}")
输出:
错误的合计:5
该程序不会报错,但输出结果仅保留了最后一轮加进去的 5。因此,累加器必须在循环开始前完成初始化。
同理,print() 输出语句的放置位置决定了信息输出的粒度:
- 置于循环体内:每轮迭代均输出一行,适合展示中间变动明细(如逐笔流水明细);
- 置于循环体外:循环全部结束后仅输出一次,适合展示最终汇总结果(如期末总额)。
实际编写时应根据业务需求选择合适的输出位置。
5.3.3 循环结构与条件结构的组合
案例:检查 1 到 10 的所有整数,逐个打印其中能被 3 整除的数,并统计此类数值的总个数。
取模运算符 % 用于计算整数除法的余数。当 number % 3 == 0 成立时,表明 number 除以 3 的余数为 0,即能被 3 整除。
n = 10
count = 0  # 计数器初始化为 0

# 对 1 到 n 之间的每一个数 number:
#     如果 number 能被 3 整除:
#         打印 number,并把计数器 count 加 1
for number in range(1, n + 1):
    if number % 3 == 0:
        print(number)
        count = count + 1  # 也可简写为 count += 1

print(f"能被 3 整除的数共有 {count} 个")
输出:
3
6
9
能被 3 整除的数共有 3 个
在此代码中,外层 for 循环遍历整数,内层 if 语句负责条件筛选。只有当取出的数为 3、6、9 时条件才成立,进而执行缩进在 if 内部的打印与计数。
缩进层级直接决定了统计口径:
- 缩进在
if内部:仅在条件成立时执行,统计的是“符合条件的样本数”; - 若与
if左对齐:每轮循环无条件执行,统计的则是“全部样本数”(结果将变为 10)。
5.3.4 应用:累计逐月增加的计划支出
某业务部门编制季度预算:第 1 个月计划支出 1200 元,此后每月比上月递增 100 元。若编制 3 个月的预算,各月支出依次为 1200 元、1300 元和 1400 元。
分析月份序号 month 与当月支出间的数量关系可知:第 1 个月增加 0 个 100 元,第 2 个月增加 1 个 100 元,第 3 个月增加 2 个 100 元。由此可得:
根据该算式,可在循环体内先计算当月计划支出,再累加至总预算(后续代码普遍采用 += 复合赋值简写):
month_count = 3
total_cost = 0

# 对 1 到 month_count 之间的每一个月份 month:
#     计算当月支出 monthly_cost
#     当月支出 monthly_cost 累加到 total_cost 上
#     打印当月支出计划
for month in range(1, month_count + 1):
    monthly_cost = 1200 + (month - 1) * 100
    total_cost = total_cost + monthly_cost
    print(f"第 {month} 月:计划支出 {monthly_cost} 元")

print(f"计划支出合计:{total_cost} 元")

if month_count > 0:
    average_cost = total_cost / month_count
    print(f"月均计划支出:{average_cost:.2f} 元")
else:
    print("没有预算月份,无法计算月均支出")
输出:
第 1 月:计划支出 1200 元
第 2 月:计划支出 1300 元
第 3 月:计划支出 1400 元
计划支出合计:3900 元
月均计划支出:1300.00 元
该程序的执行流程包含三个清晰环节:
- 循环准备:初始化
month_count = 3与total_cost = 0;range(1, 4)生成序列1, 2, 3,确定执行 3 轮迭代; - 逐轮迭代:每轮依次计算当月支出、累加至总额并打印明细(第 1 轮 1200 元、累计 1200 元;第 2 轮 1300 元、累计 2500 元;第 3 轮 1400 元、累计 3900 元);
- 退出与汇总:序列遍历完毕退出循环,执行后续未缩进语句,输出支出合计 3900 元,并通过
if month_count > 0:分支计算月均支出 1300.00 元。
代码中包含两处关键设计:
- 变量分工明确:
monthly_cost为循环体内的局部临时变量,每轮重新赋值;累加器total_cost在循环外部初始化,用于跨轮次累加; - 防范除零异常:
if month_count > 0:用于防范分母为 0 触发的ZeroDivisionError。若month_count为0,range(1, 1)为空序列,循环体不执行,下方的else分支直接提示无预算月份。
随堂练习:将 5.3.1 节求和程序中的 n 分别设为 1、10 和 0,并将 5.3.3 节统计程序中的 n 分别设为 2、3 和 12。先在纸上推算输出,再运行程序验证边界情况。
扩展实现:先存入列表,再遍历汇总
原程序采用“边计算边累加”的模式,各月明细作为临时变量在循环结束后不再保留。若后续需复用各月明细数据,可采用“先存储明细,再遍历汇总”的两阶段处理模式。
此处引入 Python 最常用的数据容器——列表(List):
- 概念:列表用于按顺序存放一组数据,使用方括号
[]表示,元素间用逗号隔开(如[1200, 1300, 1400]); - 操作:空列表写作
monthly_costs = [],通过monthly_costs.append(值)可将数据依次追加至末尾(5.7 节将系统讲解)。
month_count = 3
monthly_costs = []  # 创建空列表,用于保存各月支出明细

# 步骤 1:计算各月预算并存入列表
for month in range(1, month_count + 1):
    cost = 1200 + (month - 1) * 100
    monthly_costs.append(cost)
    print(f"第 {month} 月:计划支出 {cost} 元")

# 步骤 2:直接遍历列表元素累加总额
total_cost = 0
for cost in monthly_costs:
    total_cost += cost

print(f"计划支出合计:{total_cost} 元")

if month_count > 0:
    average_cost = total_cost / month_count
    print(f"月均计划支出:{average_cost:.2f} 元")
else:
    print("没有预算月份,无法计算月均支出")
该写法的输出结果与原程序完全一致。在步骤 2 中,for cost in monthly_costs: 直接按顺序取出列表中的每个数值,无需借助 range()。这种将“数据生成”与“数据统计”解耦为独立环节的模式,是批量数据处理的基本范式。
5.4 条件成立时继续执行:while 循环
5.4.1 重复次数未知的场景与 while 循环
前述 for 循环适用于循环前即可确定起止范围或执行次数的任务。但在许多经济管理与业务测算场景中,循环的执行次数在运行前往往无法预先得知。
例如为创业项目筹集 2500 元启动资金:若使用 for 循环,很难预先设定 range() 的终点——终点设小了会导致未达标提前终止,设大了又会导致达标后无效空转。程序应在何时停止,完全取决于累计资金的实时变化。这种次数未知、需依据运行状态动态判断是否继续的场景,适合使用 while 循环。
案例:某创业项目已有启动资金 1000 元,此后每个月底固定追加 600 元(不计利息且无支出)。需要经过几个月,储备资金才能达到或超过 2500 元的目标?
按月份推算:第 1 个月末增至 1600 元,第 2 个月末增至 2200 元,第 3 个月末增至 2800 元(达标)。转化为程序控制逻辑即为:只要账面资金小于 2500 元,就继续追加;一旦达到或超过 2500 元,立即停止。
reserve = 1000
target = 2500
monthly_addition = 600
months = 0  # 计数器初始化:尚未开始月末追加时,月数为 0

# 当储备资金 reserve 小于目标金额 target 时:
#     追加一个月资金,并将月份计数器 months 加 1
while reserve < target:
    reserve += monthly_addition
    months = months + 1
    print(f"第 {months} 个月末:资金 {reserve:.2f} 元")

print(f"达到目标需要 {months} 个月")
输出:
第 1 个月末:资金 1600.00 元
第 2 个月末:资金 2200.00 元
第 3 个月末:资金 2800.00 元
达到目标需要 3 个月
语句 while reserve < target: 表示:只要条件 reserve < target 为真,便重复执行下方缩进的代码块。每追加一笔资金,月份计数器 months 增 1;每轮迭代结束,程序均返回 while 语句处,根据最新资金余额重新判断条件是否依然成立。
5.4.2 先检查条件,再执行循环体
while 循环的基本语法结构如下:
设定初始状态(初始化变量)

while 条件表达式:
    条件成立时重复执行的业务语句
    推进循环状态的更新语句

循环结束后继续执行的语句
其中,while 后的条件表达式求值结果非真(True)即假(False)。筹资案例各阶段的条件判断与执行流程如下表所示:
| 条件检查轮次 | 检查时的 reserve |
条件 reserve < 2500 |
是否进入循环体 | 本轮执行后的资金与月数 |
|---|---|---|---|---|
| 第 1 次检查 | 1000 元 | True |
是 | 1600 元,1 个月 |
| 第 2 次检查 | 1600 元 | True |
是 | 2200 元,2 个月 |
| 第 3 次检查 | 2200 元 | True |
是 | 2800 元,3 个月 |
| 第 4 次检查 | 2800 元 | False |
否 | 保持 2800 元、3 个月,退出循环 |
从表中可总结出 while 循环的两个核心运行特征:
- 先判断后执行(前测循环):条件检查在每轮循环体执行前进行。若初始资金本身已达标(如
reserve = 3000),首次检查即为False,循环体一次也不执行,直接输出 0 个月; - 条件检查次数比循环体执行次数多 1 次:本例中循环体共执行 3 次,而条件共检查了 4 次。第 3 轮资金增至 2800 元后,程序不会在赋值语句处立即中断,而是将本轮剩余语句执行完毕,返回
while处进行第 4 次检查,判定为False后才正式退出。
5.4.3 循环推进条件与无限循环防范
编写 while 循环时,必须确保三个环节紧密衔接:循环前设定初始状态、循环头明确继续条件、循环体内持续推进状态使其向终止边界靠拢。
在筹资案例中,reserve 从 1000 起步,继续条件为 reserve < 2500,每轮固定递增 600。由于余额单调递增,必然在有限步内达到或超过 2500 元,使条件转为 False 并正常终止。
若破坏了这一推进机制,循环将无法终止:
| 常见的代码疏漏 | 资金余额的变化情况 | 运行后果与原因分析 |
|---|---|---|
漏写了 reserve += monthly_addition |
账面资金始终停留在初始的 1000 元 | 条件 1000 < 2500 恒为 True,循环无法停止 |
把每月追加额 monthly_addition 设为 0 |
每次增加 0 元,资金保持不变 | 只要初始资金不足,就永远无法达到 2500 元 |
把 monthly_addition 误写为负数 |
资金非但不增,反而逐月减少 | 与 2500 元的目标差距越来越大,条件恒为 True |
把继续条件写成 reserve != target |
资金从 2200 元直接增至 2800 元,跳过 2500 元 | 余额此后不再等于 2500 元,因错过精确相等点而无法停止 |
一旦条件表达式恒为 True 且缺乏其他跳出机制,程序便会陷入无限循环(Infinite Loop,俗称死循环)。运行程序时,若屏幕持续刷屏或光标长时间停滞,可点击编辑器上的“停止”按钮,或在终端按下 Ctrl + C 强制终止,并排查循环体内是否遗漏了状态更新语句。
特别注意表中最后一行:在业务测算中,针对“达到或超过目标”的需求,继续条件应写作 reserve < target(不足目标时继续),而不宜写作 reserve != target。因为资金按 600 元跳跃递增,会直接从 2200 元跨至 2800 元,并未停留在 2500 元处,使用 != 将导致条件恒为真。
提示(金额单位与浮点数精度):为聚焦流程控制,本例金额均采用整数“元”。在实际金融系统中,通常避免直接使用浮点数(
float)作为精确比较边界,具体原因详见章末“补充说明”。
5.4.4 for 循环与 while 循环的选用原则
for 循环与 while 循环均能实现重复计算,实际选用的核心判断标准为:循环开始前,能否预先确定重复范围或次数。
| 典型业务任务 | 推荐使用的循环 | 选用依据 |
|---|---|---|
| 计算从 1 到 N 的整数之和 | for 配合 range() |
起止范围已知,直接按整数序列遍历最简洁 |
| 依次核算全年 1 至 12 月的预算开支 | for 配合 range() |
固定为 12 个月,按月份编号顺序推进即可 |
| 资金不足时按月追加,直到攒够目标 | while |
事先未知需要几个月,需根据每轮更新后的余额判断是否继续 |
| 持续接收收银员扫码录入,直到结账 | while |
事先未知商品件数,何时结束取决于收银员输入的结账指令 |
从语法能力上看,任何用 for 编写的遍历任务均可用 while 实现。例如计算 1 到 n 的整数之和改写为 while 循环:
n = 5
total = 0
number = 1

while number <= n:
    total += number
    number += 1

print(f"从 1 到 {n} 的整数之和:{total}")
输出:
从 1 到 5 的整数之和:15
对比两种写法:使用 for number in range(1, n + 1): 时,数值递增由 range() 自动维护;而改用 while 循环时,则需手动维护三个环节:
| 控制环节 | 对应的代码 | 作用说明 |
|---|---|---|
| 设定初值 | number = 1 |
手动准备第一个参与累加的数字 |
| 检查边界 | number <= n |
只要尚未超过 n 就继续累加(确保 n 本身被包含) |
| 手动步进 | number += 1 |
每累加完一个数,手动将 number 加 1 |
在 while 写法中,若漏写 number += 1,变量将始终停在 1 引发死循环。因此,凡是次数确定、范围已知的遍历任务,应优先选用 for 循环,以精简代码并规避漏写步进语句的风险。
随堂练习:将 5.4.1 节筹资程序中的目标金额 target 分别改为 2200、2500 和 1000 元。先在纸上推算各自所需的月数,再运行代码验证。这三个数值分别对应恰好达标、跨过目标以及初始即达标三种典型边界。
5.5 改变循环流程:break 与 continue
5.5.1 找到满足要求的结果后提前结束:break
在数据查找或方案测算中,若已在中途获取符合条件的结果,继续遍历剩余数据便毫无必要。
Python 提供了 break 语句,用于立即终止并跳出当前所在的那一层循环。一旦执行到 break,程序不仅略过本轮循环体内的剩余语句,还会直接跳出整个循环,转去执行循环下方的后续代码。
案例(目标利润测算):某产品销售单价为 50 元,单位变动成本为 30 元,固定成本总额为 1000 元。假设产销平衡,请在 1 至 200 件的整数销量范围内,找出使利润达到或超过 1000 元的最小销量。
根据本量利分析公式:\text{利润} = (\text{单价} - \text{单位变动成本}) \times \text{销量} - \text{固定成本}。销量从 1 件起逐件递增,由于利润随销量增加而单调上升,第一个使利润达标的销量即为所求的最小销量,找到后即可执行 break 终止循环:
unit_price = 50
unit_cost = 30
fixed_cost = 1000
target_profit = 1000
found = False  # 标志变量初始化:查找开始前记为 False(表示“尚未找到”)

# 对 1 到 200 之间的每一个候选销量 quantity:
#     计算对应利润 profit
#     如果 profit 达到目标利润 target_profit:
#         记录已找到、打印结果,并立即跳出循环
for quantity in range(1, 201):
    profit = (unit_price - unit_cost) * quantity - fixed_cost
    if profit >= target_profit:
        found = True
        print(f"首个达标销量:{quantity} 件")
        print(f"对应利润:{profit} 元")
        break

if not found:
    print("在 1 至 200 件的范围内没有找到达标销量")

print("查找结束")
输出:
首个达标销量:100 件
对应利润:1000 元
查找结束
程序从 1 件开始依次测算:算至 99 件时利润为 980 元(未达标);算至 100 件时利润恰达 1000 元,if 条件成立,程序打印结果并执行 break 直接跳出循环,后续 101 至 200 件不再参与计算。
布尔变量 found 称为标志变量(Flag),用于记录“是否已找到目标”的状态:循环前初始化为 False;一旦在循环中找到目标则更新为 True。循环结束后检查该变量,若 not found 为真,表明遍历完毕仍未达标(可将 target_profit 改为 5000 元观察运行效果)。
5.5.2 跳过本次处理,继续下一次:continue
若在处理数据时遇到某条特殊记录,仅需跳过当前轮次、直接进入下一轮迭代,而无需终止整个循环,可以使用 continue 语句。其作用为:立即结束当前这轮迭代,跳过循环体内其下方的剩余语句,直接开始下一轮迭代。
案例:某商品展销会为期 7 天,其中第 3 天闭馆休整。开展期间每天需支付 80 元场地维护费,闭馆当天免收维护费。请编写程序,打印实际开展的日期,并统计开展总天数与维护费总额。
closed_day = 3
daily_cost = 80
open_days = 0
total_cost = 0

# 对第 1 到第 7 天中的每一天 day:
#     如果 day 是闭馆日,直接跳过本轮后续核算
#     否则,将开展天数加 1、累加维护费并打印开展日期
for day in range(1, 8):
    if day == closed_day:
        continue

    open_days += 1
    total_cost += daily_cost
    print(f"第 {day} 天开展")

print(f"开展天数:{open_days} 天")
print(f"维护费合计:{total_cost} 元")
输出:
第 1 天开展
第 2 天开展
第 4 天开展
第 5 天开展
第 6 天开展
第 7 天开展
开展天数:6 天
维护费合计:480 元
当 day 取值为 3 时,day == closed_day 成立,程序执行 continue,略过下方增加天数、累加费用及打印的三行语句,直接进入第 4 天的迭代。
若此处误写为 break,整个循环将在第 3 天彻底终止,导致第 4 至 7 天全部被遗漏。
此案例也可将后三行代码直接缩进在 if day != closed_day: 内部,效果完全相同。引入 continue 的价值在于充当卫语句(Guard Clause):在循环体开头先过滤异常或特殊情况(如闭馆日、缺失值),后续核心业务代码便无需层层嵌套在 if 块中,使代码结构更扁平清晰。
5.5.3 continue 在 for 与 while 循环中的跳转差异
使用 continue 时,需注意其在 for 与 while 中的跳转行为差异:
- 在
for循环中:执行continue后,解释器自动从序列中取出下一个元素,循环正常向前推进; - 在
while循环中:执行continue后,程序直接跳回while开头重新检查条件。若状态更新语句写在continue下方,该更新语句将被一并跳过,导致循环变量无法向前推进。
例如用 while 循环检查第 1 至 4 号记录(跳过 2 号记录),稳妥做法是在执行 continue 判断前完成步进递增:
record_no = 0

while record_no < 4:
    record_no += 1  # 先自增编号,确保触发 continue 时不会卡在原值
    if record_no == 2:
        continue
    print(f"检查记录 {record_no}")
输出:
检查记录 1
检查记录 3
检查记录 4
若将 record_no += 1 放置于循环体末尾:当检查完 1 号记录、record_no 增至 2 时,if record_no == 2: 触发 continue 跳过末尾的自增语句;程序回到循环头时 record_no 仍为 2,便会反复触发 continue 陷入无限循环。这也体现了在范围确定的任务中优先选用 for 循环的稳健性。
5.5.4 区分 continue、break 与 return
结合第二章介绍的 return 语句,三种改变代码执行顺序的控制语句对比如下:
| 控制语句 | 中断范围 | 执行后跳转位置 | 典型使用场景 |
|---|---|---|---|
continue |
仅结束当前这轮迭代 | 回到本层循环开头,进入下一轮迭代 | 遇到闭馆日、缺失值等特殊数据时略过不计 |
break |
结束当前所在的那层循环 | 跳至该循环体下方的首条语句 | 已找到目标结果,无需继续测算剩余候选值 |
return |
结束整个函数的执行 | 带着返回值直接退回调用该函数的位置 | 函数已算出最终结果,直接返回并退出函数 |
在语法限制上,break 与 continue 仅能写在循环体内部;而 return 仅能写在函数(def)内部。在函数内的循环中执行 break 仅跳出当前循环,函数后续代码继续运行;而一旦执行 return,无论嵌套了几层循环,整个函数均立即终止并返回。
随堂练习:将 5.5.2 节展销会案例中的闭馆日 closed_day 分别改为 1 和 7。先在纸上写出使用 continue 和 break 时的各自输出,再运行代码核对。
5.6 在函数中组织循环
5.6.1 用参数决定计算范围
在工程实践中,通常将循环逻辑封装在独立的函数内部,通过形参传递计算范围或目标值。函数编写完成后,调用时只需传入不同实参即可处理不同规模的数据,无需修改函数内部逻辑。
def sum_integers(n: int) -> int:
    """返回从 1 到 n 的整数之和,n 为非负整数。"""
    total = 0
    for number in range(1, n + 1):
        total += number
    return total


print(sum_integers(5))
print(sum_integers(100))
print(sum_integers(0))
输出:
15
5050
0
每次调用 sum_integers() 时,函数均在局部作用域内将累加器 total 初始化为 0,多次调用互不干扰。当传入 n = 0 时,range(1, 1) 为空序列,循环体不执行,直接返回初始值 0。
提示(函数中的循环结构):从数学角度,连续整数求和可直接使用高斯公式
n * (n + 1) // 2。此处采用逐项累加,旨在展示函数内部“初始化累加器 \rightarrow 循环更新状态 \rightarrowreturn返回结果”的标准结构。
5.6.2 返回合计应等待循环完成
在 sum_integers() 中,return total 与 for 左对齐,位于循环体外部。这保证了所有整数全部累加完毕后,才返回最终合计值。
若将 return total 误缩进至 for 循环体内部,执行结果将发生改变:
# 错误示范:将 return 误写入循环体内,导致第一轮迭代时函数即提前结束
def incorrect_sum(n: int) -> int:
    total = 0
    for number in range(1, n + 1):
        total += number
        return total  # 错误:第一轮刚加完 1,函数便立即结束并返回


print(incorrect_sum(5))
print(incorrect_sum(0))
输出:
1
None
当传入 5 时,第 1 轮将 1 加至 total 后立即触发 return total,函数随即终止并返回 1,后续数字均未参与计算。此外,当传入 0 时,循环体不执行,无法触发内部的 return,函数执行至末尾默认返回 None。
因此,在函数中组织循环时,return 的放置位置需遵循两条原则:
- 汇总统计类任务(如求和、算均值、统计达标总数):必须等待循环全部执行完毕,
return应置于循环体外部(与for或while左对齐); - 查找首个目标类任务(如寻找最小达标销量、排查首笔违规订单):一旦在循环中找到目标即可终止,可将
return置于循环体内的if分支中直接返回。
5.6.3 两个状态依次更新:斐波那契数列
累加器与计数器在每轮循环中仅维护一个状态变量。但在部分递推问题中,下一步的计算依赖于前两步的历史状态。以**斐波那契数列(Fibonacci Sequence)**为例:规定第 0 项为 0,第 1 项为 1;从第 2 项起,每一项均等于其前两项之和:
项号:0  1  2  3  4  5  6   7
数值:0  1  1  2  3  5  8  13
推算第 6 项(8)时,仅需知道紧邻的第 4 项(3)与第 5 项(5),更早的历史数值无需保留。因此,只需定义两个状态变量,犹如两格宽的“滑动窗口”,每算出一项新数值便向右平移一格,始终保存最新的相邻两项。
定义变量 previous(前一项)与 current(当前项),初值分别设为第 0 项 0 和第 1 项 1。每轮循环中,先用二者之和算出下一项 next_value,再依次将 current 赋给 previous、将 next_value 赋给 current 完成平移:
def fibonacci(n: int) -> int:
    """返回斐波那契数列第 n 项,n 为非负整数,第 0 项为 0。"""
    previous = 0
    current = 1

    # 重复平移 n 次:
    #     先算出下一项 next_value,再将 previous 和 current 依次向右递推一项
    for step in range(n):
        next_value = previous + current
        previous = current
        current = next_value

    return previous


print(fibonacci(0))
print(fibonacci(1))
print(fibonacci(2))
print(fibonacci(7))
输出:
0
1
1
13
代码中 range(n) 控制平移执行 n 次。前 5 轮平移后两变量的取值演变如下表所示:
| 已完成的平移轮次 | previous 的值 |
current 的值 |
两个变量分别对应的数列项 |
|---|---|---|---|
| 0(初始状态) | 0 | 1 | 第 0 项、第 1 项 |
| 1 | 1 | 1 | 第 1 项、第 2 项 |
| 2 | 1 | 2 | 第 2 项、第 3 项 |
| 3 | 2 | 3 | 第 3 项、第 4 项 |
| 4 | 3 | 5 | 第 4 项、第 5 项 |
| 5 | 5 | 8 | 第 5 项、第 6 项 |
由表格可知:每完成 1 次平移,两变量对应的项号同时增 1。因此,完成第 n 次平移后,previous 恰好保存第 n 项,current 则保存第 n + 1 项。函数最终返回 previous;当 n = 0 时,循环执行 0 次,直接返回 previous 的初值 0,与定义吻合。
更新状态时必须注意赋值次序:必须先用临时变量 next_value 保存两项之和,再去更新 previous 与 current。若省去临时变量直接执行 previous = current,previous 原有的旧值将被提前覆盖,导致后续加法变成两个 current 相加(详见核心内容 Part I 练习 4)。
随堂练习:根据上表继续推算第 6 轮和第 8 轮结束后两变量的值,调用 fibonacci(6) 与 fibonacci(8) 验证,并结合表格说明为何函数返回的是 previous 而非 current。
核心内容 Part I 练习
以下 4 道练习综合运用算术运算、条件分支、自定义函数与循环结构(暂不使用列表)。编写代码前,建议先明确三个问题:需要定义哪几个变量保存中间状态?每轮循环如何更新它们?循环在什么条件下结束?
练习 1:计算 1 至 N 中所有奇数的和
编写函数,接收非负整数 n,返回从 1 到 n 之间所有奇数的总和(包含边界奇数;当 n = 0 时返回 0)。
提示:既可在 range(1, n + 1) 循环中配合 if number % 2 != 0 筛选累加,也可直接利用 range(1, n + 1, 2) 生成奇数序列累加。
测试输入 n |
期望返回值 | 计算过程说明 |
|---|---|---|
| 0 | 0 | 范围内没有奇数,返回初始和 0 |
| 1 | 1 | 只有 1 这一个奇数 |
| 6 | 9 | 累加奇数:1 + 3 + 5 = 9 |
| 7 | 16 | 包含边界奇数:1 + 3 + 5 + 7 = 16 |
练习 2:计算资金达到目标所需的月份数
编写函数,接收初始资金、每月底追加金额和目标金额三个参数,返回使累计资金达到或超过目标金额所需的最少整月数。金额均以整数“元”为单位,其中初始资金与目标金额为非负整数,每月追加额为正整数(不计利息且无支出)。
要求使用 while 循环实现;若初始资金本身已达到或超过目标金额,函数直接返回 0。
| 初始资金(元) | 每月追加(元) | 目标金额(元) | 期望月份数 | 业务场景说明 |
|---|---|---|---|---|
| 1000 | 600 | 2200 | 2 | 经过 2 个月末刚好攒到 2200 元 |
| 1000 | 600 | 2500 | 3 | 经过 3 个月末攒到 2800 元(跨过目标线) |
| 2500 | 600 | 2500 | 0 | 初始资金已刚好达标,无需等待 |
| 3000 | 600 | 2500 | 0 | 初始资金已超过目标,直接返回 0 |
练习 3:在预算与库存限制内采购
某企业行政部门采购同款办公用品。已知单价为正整数,预算总额和供应商最大库存量均为非负整数(元与件)。每购入一件商品,便从剩余预算中扣减单价。当剩余预算不足以再买一件或采购件数达到库存上限时停止采购。
请编写函数,返回最多可采购的商品件数。要求结合使用 for 循环、range()、break 语句与计数器变量:每轮循环先检查剩余预算是否充足,若充足则扣减预算并递增采购件数;不足则立即执行 break 终止循环。
| 库存数量(件) | 单价(元) | 预算总额(元) | 期望采购件数 | 边界检查重点 |
|---|---|---|---|---|
| 10 | 80 | 250 | 3 | 买完 3 件后还剩 10 元,不够再买第 4 件 |
| 10 | 80 | 240 | 3 | 买完 3 件后预算刚好花光(剩 0 元) |
| 2 | 80 | 250 | 2 | 预算虽然还有富余,但库存总共只有 2 件 |
| 10 | 80 | 0 | 0 | 预算为 0 元,1 件也买不了 |
| 0 | 80 | 250 | 0 | 库存为 0 件,有钱也买不到 |
练习 4:排查斐波那契数列中的更新错误
下方给出的 incorrect_fibonacci(n) 函数试图计算斐波那契数列第 n 项(第 0 项为 0,第 1 项为 1,n 为非负整数)。该代码省去了临时变量,因循环体内两行赋值顺序不当,导致旧值被提前覆盖:
def incorrect_fibonacci(n: int) -> int:
    """错误示范:更新时提前覆盖了后续计算仍需使用的旧值。"""
    previous = 0
    current = 1

    for step in range(n):
        previous = current
        current = previous + current

    return previous


print(incorrect_fibonacci(3))
运行该错误代码,输出结果为:
4
按定义,斐波那契数列前几项依次为 0, 1, 1, 2,第 3 项应为 2,而程序却算出了 4。
请先不要上机运行,严格按照循环体内赋值语句的顺序在纸上填写变量追踪表,找出变量从哪一轮开始偏离正确结果(每行填写该轮两句赋值全部完成后的数值):
| 已完成的迭代轮次 | previous 的当前值 |
current 的当前值 |
|---|---|---|
| 0(初始状态) | 0 | 1 |
| 1 | 待填写 | 待填写 |
| 2 | 待填写 | 待填写 |
| 3 | 待填写 | 待填写 |
填表定位原因后,请引入临时变量修正代码,并用下方测试用例逐一核验。思考:为何仅测试 n = 1 时无法发现该逻辑错误?
测试输入 n |
期望返回值 | 验证重点 |
|---|---|---|
| 0 | 0 | 循环执行 0 次,检验初始边界 |
| 1 | 1 | 循环 1 次(注意:错误代码在此处也会巧合输出 1) |
| 2 | 1 | 循环 2 次,检验第 1 轮加法的结果是否被正确传递下来 |
| 3 | 2 | 暴露原代码错误的测试用例 |
| 6 | 8 | 连续迭代多轮,检验递推链条是否稳定 |
参考答案与编程指引
练习 1:计算 1 至 N 中所有奇数的和
def sum_odd_numbers(n: int) -> int:
    """返回 1 至 n 中奇数的和,n 为非负整数。"""
    total = 0
    for number in range(1, n + 1, 2):
        total += number
    return total


print(sum_odd_numbers(0))
print(sum_odd_numbers(1))
print(sum_odd_numbers(6))
print(sum_odd_numbers(7))
输出:
0
1
9
16
编程指引:设置步长为 2 即 range(1, n + 1, 2),序列从 1 开始每次加 2,直接生成 1, 3, 5, ...,省去循环内判断奇偶的步骤。终点设为 n + 1,保证当 n 本身为奇数时也能包含在内。若使用 range(1, n + 1) 配合 if number % 2 != 0: 筛选累加,逻辑同样正确。
练习 2:计算资金达到目标所需的月份数
def months_to_target(initial: int, monthly: int, target: int) -> int:
    """按整数元累计;初始资金和目标非负,每月追加额为正。"""
    reserve = initial
    months = 0

    while reserve < target:
        reserve += monthly
        months += 1

    return months


print(months_to_target(1000, 600, 2200))
print(months_to_target(1000, 600, 2500))
print(months_to_target(2500, 600, 2500))
print(months_to_target(3000, 600, 2500))
输出:
2
3
0
0
编程指引:变量 months 记录追加月数,循环前初始化为 0。若传入的初始资金 initial 已达到目标,首次检查 while reserve < target 即为 False,跳过循环体直接返回 0。初始资金不足时,每轮循环追加资金并将月数加 1;一旦某月末资金达标,下一轮条件判定为 False 退出循环,此时 months 即为所需的最少整月数。
练习 3:在预算与库存限制内采购
def count_affordable_items(stock: int, unit_price: int, budget: int) -> int:
    """返回可采购件数;库存和预算非负,单价为正,参数均为整数。"""
    remaining = budget
    item_count = 0

    for attempt in range(stock):
        if remaining < unit_price:
            break
        remaining -= unit_price
        item_count += 1

    return item_count


print(count_affordable_items(10, 80, 250))
print(count_affordable_items(10, 80, 240))
print(count_affordable_items(2, 80, 250))
print(count_affordable_items(10, 80, 0))
print(count_affordable_items(0, 80, 250))
输出:
3
3
2
0
0
编程指引:本题需同时兼顾库存与预算两大约束。代码采用两步拆解:外层 for attempt in range(stock): 限制最多尝试采购 stock 次,确保不超库存;循环体内先检查剩余预算是否足够买一件,不足则立即执行 break 终止,充足则扣减预算并递增采购件数。当库存为 0 时,range(0) 为空序列,直接返回 0。
练习 4:排查斐波那契数列中的更新错误
按错误代码逐步推算出的变量演变为:
| 已完成的迭代轮次 | previous 的当前值 |
current 的当前值 |
错误发生过程分析 |
|---|---|---|---|
| 0(初始状态) | 0 | 1 | 初始状态正常 |
| 1 | 1 | 2 | 先执行 previous = current 变为 1;再算 current = 1 + 1 变为 2 |
| 2 | 2 | 4 | 先执行 previous = current 变为 2;再算 current = 2 + 2 变为 4 |
| 3 | 4 | 8 | 先执行 previous = current 变为 4;再算 current = 4 + 4 变为 8 |
原因分析:第 1 轮迭代中,语句 previous = current 将 previous 原有的 0 覆盖为 1。紧接着计算 current = previous + current 时,原本应计算旧的 previous(0)加 current(1),但由于 previous 已被改写为 1,实际算成了 1 + 1 = 2。此后每轮迭代均将数值翻倍,偏离了递推规则。
仅测试 n = 1 时无法发现错误,是因为循环只执行第 1 轮,previous 被更新为 1,函数返回的 previous 恰好也是 1,与真实值巧合重合。只要测试 n = 2 或 n = 3,错误就会暴露。
修正后的代码:
def fibonacci(n: int) -> int:
    """返回斐波那契数列第 n 项,n 为非负整数,第 0 项为 0。"""
    previous = 0
    current = 1

    for step in range(n):
        next_value = previous + current
        previous = current
        current = next_value

    return previous


print(fibonacci(0))
print(fibonacci(1))
print(fibonacci(2))
print(fibonacci(3))
print(fibonacci(6))
输出:
0
1
1
2
8
编程指引:多变量互相传递数值时,必须明确旧值在后续是否仍需使用;若仍需使用,必须先用临时变量保存中间计算结果。测试包含循环的函数时,应至少覆盖循环 0 次、循环 1 次以及多轮连续迭代三种输入场景。
核心内容 Part II
核心内容 Part I 处理的数字,要么由 range() 生成,要么由公式直接计算。而在实际商业环境中,待处理的数据往往是一组没有固定规律的离散记录——例如多笔订单金额或连续多日的营业额。
核心内容 Part II 引入 Python 中最常用的有序数据容器——列表(List),介绍如何利用循环批量处理业务数据集。内容按以下四个递进层次展开:
| 学习层次 | 对应小节 | 核心内容与应用场景 |
|---|---|---|
| 1. 列表基础与遍历 | 5.7、5.8 | 用列表存放订单或流水数据,配合 for 循环完成汇总、筛选与核算 |
| 2. 组合方案推演 | 5.9 | 用双层嵌套循环遍历“价格 \times 销量”组合网格,测算多方案利润 |
| 3. 遍历辅助工具 | 5.10、5.11 | 用 enumerate() 同时获取序号与数据;掌握循环 else 子句的执行逻辑 |
| 4. 交互式持续录入 | 5.12 | 用 while True 配合哨兵值,实现“逐笔键盘录入 + 事后统一汇总” |
建议先掌握 5.7 和 5.8 节的列表遍历方法,再依次学习后续内容。
5.7 先把多条数据放在一起:列表的三个基本操作
在商业数据处理中,三笔订单金额 85.0、99.0、120.0 元之间并无固定步长,无法用 range() 生成;为每笔订单单独定义变量(amount1、amount2……)不仅繁琐,更无法放入循环中批量处理。
要批量处理这批数据,第一步需将零散数据按顺序存入同一个数据容器。在 Python 中,最常用的有序容器是列表(List)。本节先介绍配合循环最常用的三项基本操作:定义列表、向末尾追加元素、按位置读取元素。
5.7.1 定义列表:用方括号保存一组数据
order_amounts = [85.0, 99.0, 120.0]

print(order_amounts)
print(f"订单笔数:{len(order_amounts)}")
输出:
[85.0, 99.0, 120.0]
订单笔数:3
在 Python 中,使用方括号 [] 即可创建列表,各数据项之间用逗号 , 分隔。列表中的每一项数据称为一个元素(Element)。内置函数 len(order_amounts) 用于获取列表的元素个数(本例为 3)。
列表会保留元素的存入顺序,且允许包含重复数值。若初始阶段尚无数据,可写作 order_amounts = [] 创建一个空列表(此时 len 为 0),后续再动态追加元素。
5.7.2 添加元素:append()
在日常记账与数据采集过程中,数据通常是逐笔产生的。调用列表的 .append() 方法,可将新元素追加至列表末尾:
expenses = []
expenses.append(25.0)
expenses.append(68.5)

print(expenses)
print(f"已记录支出:{len(expenses)} 笔")
输出:
[25.0, 68.5]
已记录支出:2 笔
代码先创建空列表,执行 expenses.append(25.0) 后存入第一笔支出 [25.0];再执行 expenses.append(68.5),数值追加至末尾变为 [25.0, 68.5],列表长度随之变为 2。
提示(不要将 append 的返回值赋回给列表变量):
.append()属于原地修改(In-place Mutation),它会直接改变原列表,其方法调用返回值为None。因此添加元素只需单独书写expenses.append(25.0),切勿写成expenses = expenses.append(25.0),否则列表变量会被None覆盖。
5.7.3 按位置取值:索引从 0 开始
若要单独读取列表中的某一项元素,可在列表名后使用方括号 [] 指定其位置编号,该编号称为索引(Index)。
Python 索引遵循核心规则:索引从 0 开始编号,而非从 1 开始。
索引从 0 开始反映了底层的内存寻址机制:索引代表当前元素距离列表首地址的偏移量(Offset)。第 1 个元素紧贴起始位置,偏移量为 0;第 2 个元素偏移 1 个位置,偏移量为 1;以此类推:
| 日常表述 | Python 索引编号 | 取值表达式 | 读取的金额 |
|---|---|---|---|
| 第 1 笔订单 | 0 | order_amounts[0] |
85.0 元 |
| 第 2 笔订单 | 1 | order_amounts[1] |
99.0 元 |
| 第 3 笔订单 | 2 | order_amounts[2] |
120.0 元 |
order_amounts = [85.0, 99.0, 120.0]

print(f"第一笔金额:{order_amounts[0]:.2f} 元")
print(f"第三笔金额:{order_amounts[2]:.2f} 元")
输出:
第一笔金额:85.00 元
第三笔金额:120.00 元
包含 3 个元素的列表,合法正向索引为 0、1、2(最大索引为长度减 1)。若尝试读取 order_amounts[3],由于不存在第 4 个元素,程序将抛出 IndexError: list index out of range(索引越界异常)。对空列表 [] 读取 empty_list[0] 同样会触发越界错误。
随堂练习:定义一个包含两笔支出的列表,调用 .append() 追加第三笔支出。打印列表长度与第三笔支出金额,确认读取第三笔支出时使用的索引是否为 2。
5.8 用循环逐条处理列表中的数据
5.8.1 直接取得每一个元素
将数据存入列表后,使用 for 循环逐项读取的语法与 range() 一致,只需将 in 后面的对象替换为列表名:
expenses = [25.0, 68.5, 16.5]

# 对支出列表 expenses 中的每一笔金额 expense:
#     按格式打印 expense
for expense in expenses:
    print(f"支出:{expense:.2f} 元")

print("支出明细输出完毕")
输出:
支出:25.00 元
支出:68.50 元
支出:16.50 元
支出明细输出完毕
在此代码中,复数变量名 expenses 代表整个列表,单数变量名 expense 为循环变量。3 轮迭代中,for 循环按顺序直接取出列表中的元素赋给 expense(依次为 25.0、68.5、16.5)。注意:循环变量直接接收的是元素本身的具体数值,而非位置索引。
按顺序访问容器中所有元素的过程称为遍历(Traversal)。若业务逻辑无需使用位置编号,直接书写 for expense in expenses: 是最直观的写法。若列表为空,循环体不执行,直接执行后续语句。
结合前面的 range(),for 循环的通用结构可抽象为:
for 循环变量 in 可迭代对象:
    针对当前取出的元素执行处理
**可迭代对象(Iterable)**指能够放置在 for ... in 之后、按顺序逐项提供元素的对象。除 range 与列表外,后续章节学习的字符串、字典等均属于可迭代对象。
5.8.2 销售汇总:累加、筛选与有效记录数
下面通过门店营业额统计案例,展示列表遍历、continue 过滤、累加器与计数器的综合运用。
某门店记录了连续 4 天的日营业额(元),存入列表 sales_records。数据采集中常遇漏报情况,本数据集约定:正常上报的营业额均为非负数(\ge 0),漏报日期统一记为标记值 -1.0。
现需剔除漏报记录,计算正常上报各天的营业额合计与日均营业额:
sales_records = [1200.0, -1.0, 0.0, 1500.0]
total_sales = 0.0
valid_count = 0  # 计数器:仅统计正常上报的有效天数

# 对营业额列表 sales_records 中的每一条记录 sales:
#     若 sales 为漏报标记 -1.0,则跳过本轮
#     否则将 sales 累加至 total_sales,并将有效天数 valid_count 加 1
for sales in sales_records:
    if sales == -1.0:
        continue
    total_sales += sales
    valid_count += 1

print(f"已上报天数:{valid_count} 天")
print(f"已上报销售额合计:{total_sales:.2f} 元")

if valid_count > 0:
    average_sales = total_sales / valid_count
    print(f"已上报日期的平均销售额:{average_sales:.2f} 元")
else:
    print("没有有效记录,无法计算平均值")
输出:
已上报天数:3 天
已上报销售额合计:2700.00 元
已上报日期的平均销售额:900.00 元
此处需关注两项统计口径细节:
- 严格区分“漏报(
-1.0)”与“零营业额(0.0)”:第 2 天的-1.0为缺失值,触发continue跳过,既不累加金额也不计入有效天数;第 3 天的0.0表明当天正常营业但收入为 0,属于有效经营记录,必须计入valid_count(否则将人为虚高日均营业额); - 计算均值的分母须采用
valid_count而非len(sales_records):列表总长度为 4,包含 1 天漏报。由于漏报当日实际金额未知,计算均值(2700.0 \div 3 = 900.00 元)时分母必须为有效天数valid_count。if valid_count > 0:分支可有效拦截空数据引发的除零错误。
5.8.3 订单核算:循环调用单笔处理函数
在第四章中,我们编写了计算单笔订单运费的函数;引入列表与 for 循环后,只需在循环体内调用该函数,即可完成批量订单的核算。
案例:某平台规定单笔订单满 99 元免运费,不足 99 元加收 6 元运费。现有一批订单金额列表,请逐笔计算实付金额并汇总总额。
def calculate_payment(order_amount: float) -> float:
    """计算单笔订单的实付金额,输入为非负商品金额。"""
    if order_amount >= 99.0:
        shipping_fee = 0.0
    else:
        shipping_fee = 6.0
    return order_amount + shipping_fee


def calculate_batch_payment(order_amounts: list) -> float:
    """计算批量订单的实付金额总计;空列表返回 0.0。"""
    total_payment = 0.0
    for amount in order_amounts:
        payment = calculate_payment(amount)
        total_payment += payment
    return total_payment


print(f"批量实付合计:{calculate_batch_payment([85.0, 99.0, 120.0]):.2f} 元")
print(f"空批次实付合计:{calculate_batch_payment([]):.2f} 元")
输出:
批量实付合计:310.00 元
空批次实付合计:0.00 元
三笔订单(85.0、99.0、120.0 元)经计算实付分别为 91.0、99.0 与 120.0 元,合计 310.00 元。
将逻辑拆分为两个函数体现了**职责分离(Separation of Concerns)**原则:
calculate_payment()专门负责单笔计费规则(包邮门槛与运费标准);calculate_batch_payment()专门负责列表遍历与总额汇总。
后续促销规则变更时,仅需修改单笔计算函数,汇总函数无需改动。
随堂练习:向测试列表追加一笔 98.0 元订单,推算新的实付总额并运行核对;观察传入空列表 [] 时的执行流程。
5.9 对每个对象再重复:嵌套循环
5.9.1 计算不同价格与销量的组合
在经营决策分析中,常需测算多变量联动影响。例如制定产品定价时,需测算不同候选单价(50 元、60 元)与不同预期销量(100 件、200 件)两两组合下的利润表现。
沿用本量利参数:单位变动成本 30.0 元,固定成本 1000.0 元:
测算时可按固定次序推进:先选定第 1 个单价(50.0 元),依次测算各候选销量(100 件、200 件);再选定第 2 个单价(60.0 元),重新测算各候选销量。
将一个循环完整编写在另一个循环内部,即构成嵌套循环(Nested Loop):
prices = [50.0, 60.0]
quantities = [100, 200]
unit_cost = 30.0
fixed_cost = 1000.0

# 对候选单价列表 prices 中的每一个单价 price:
#     对候选销量列表 quantities 中的每一个销量 quantity:
#         计算并打印 (price, quantity) 组合下的利润
for price in prices:
    for quantity in quantities:
        profit = (price - unit_cost) * quantity - fixed_cost
        print(f"单价 {price:.2f} 元,销量 {quantity} 件,利润 {profit:.2f} 元")
输出:
单价 50.00 元,销量 100 件,利润 1000.00 元
单价 50.00 元,销量 200 件,利润 3000.00 元
单价 60.00 元,销量 100 件,利润 2000.00 元
单价 60.00 元,销量 200 件,利润 5000.00 元
嵌套循环的运行节奏类似于钟表上的时针与分针:外层循环每前进一步,内层循环均需从头到尾完整执行一轮。
- 外层取出第 1 个单价
price = 50.0; - 内层
quantity依次取100和200,分别输出利润 1000.00 元与 3000.00 元,内层首轮结束; - 外层推进至第 2 个单价
price = 60.0; - 内层重新从头取
100和200,分别输出利润 2000.00 元与 5000.00 元。
| 执行先后序号 | 外层当前单价 price |
内层当前销量 quantity |
算出的利润 profit |
|---|---|---|---|
| 1 | 50.0 元 | 100 件 | 1000.00 元 |
| 2 | 50.0 元 | 200 件 | 3000.00 元 |
| 3 | 60.0 元 | 100 件 | 2000.00 元 |
| 4 | 60.0 元 | 200 件 | 5000.00 元 |
注意:双层嵌套循环实现的是两列表元素的全组合(笛卡尔积),内层循环体总执行次数为外层长度乘以内层长度(本例为 2 \times 2 = 4 次)。若单价有 10 个、销量有 12 个,同一代码将自动测算全部 10 \times 12 = 120 种组合。
5.9.2 break 只结束最内层循环
若调整需求:针对每一个候选单价,只需在升序排列的销量中找出首个使利润达到 2500.0 元的销量,达标后即可切换至下一单价。
此时可在内层循环加入条件判断并在达标时执行 break:
prices = [50.0, 60.0]
quantities = [100, 200, 300]  # 候选销量已按升序排列
unit_cost = 30.0
fixed_cost = 1000.0
target_profit = 2500.0

for price in prices:
    for quantity in quantities:
        profit = (price - unit_cost) * quantity - fixed_cost
        if profit >= target_profit:
            print(f"单价 {price:.2f} 元:首个达标候选销量为 {quantity} 件")
            break
输出:
单价 50.00 元:首个达标候选销量为 200 件
单价 60.00 元:首个达标候选销量为 200 件
这体现了 break 的作用域规则:break 仅跳出直接包裹它的最内层循环,不会中断外层循环。
当单价为 50.0 元时,内层测算 100 件(未达标),再测算 200 件(达标);触发 break 仅退出了当前单价下的内层销量循环(不再测算 300 件),随后程序回到外层循环取出下一单价 60.0 元,开启新一轮内层查找。
随堂练习:将目标利润 target_profit 改为 3500.0 元。推算两单价下的首个达标销量,再运行程序验证。
5.10 同时取得编号和数据:enumerate()
在输出对账单或明细表时,往往需同时展示序号(如“第 1 笔”)与对应数值。
除在外部定义计数器并在循环内手动累加外,Python 提供了内置函数 enumerate()(枚举),可在遍历列表的同时按顺序成对返回序号与元素:
order_amounts = [85.0, 99.0, 120.0]

for order_no, amount in enumerate(order_amounts, start=1):
    print(f"第 {order_no} 笔订单:{amount:.2f} 元")
输出:
第 1 笔订单:85.00 元
第 2 笔订单:99.00 元
第 3 笔订单:120.00 元
使用 enumerate() 包装列表后,每轮迭代返回组合数据 (当前序号, 当前元素)。在 for 后并列写出两个变量名 order_no, amount,解释器会自动将二者拆分赋值,该语法称为解包(Unpacking):
| 迭代轮次 | enumerate() 本轮提供的组合数据 |
赋给 order_no 的值 |
赋给 amount 的值 |
|---|---|---|---|
| 第 1 次 | (1, 85.0) |
1 | 85.0 元 |
| 第 2 次 | (2, 99.0) |
2 | 99.0 元 |
| 第 3 次 | (3, 120.0) |
3 | 120.0 元 |
参数 start=1 用于指定起始序号。若省略该参数,序号默认从 0 开始递增。需要注意,start 仅改变生成的起始序号,不会跳过列表中的任何元素。
在实际编程中:若循环体内需使用序号,采用 for i, x in enumerate(items, start=1):;若仅需处理数据本身,直接书写 for x in items:。
5.11 循环未被 break 中断时:else 子句
5.11.1 用循环 else 表达“查找结束仍未找到”
在 5.5.1 节中,我们借助标志变量 found = False 判断循环是否找到了目标。针对“遍历查找目标,若未找到则输出提示”的场景,Python 支持在循环下方直接编写与循环头左对齐的 else 子句。
其执行规则为:循环正常遍历完毕、未触发 break 时执行 else 块;一旦循环中途触发 break 跳出,else 块将被略过。
以信贷风控排查为例:检查客户历史贷款逾期天数列表 overdue_days,一旦发现逾期天数大于 0 则预警并终止排查;若全部检查完毕均无逾期,则提示“未发现逾期记录”:
overdue_days = [0, 0, 0]

for days in overdue_days:
    if days > 0:
        print(f"发现逾期记录:逾期 {days} 天")
        break
else:
    print("未发现逾期记录")

print("检查结束")
输出:
未发现逾期记录
检查结束
注意 else: 与 for 垂直左对齐。列表中元素均为 0,if days > 0: 从未成立因而未触发 break。循环遍历完毕正常退出时,程序便进入 else 子句输出提示。
不同输入列表下的执行路径对比如下:
输入列表 overdue_days |
循环结束方式 | 是否执行循环下方的 else |
|---|---|---|
[0, 0, 0](全部正常) |
3 个元素全部检查完毕,未触发 break |
执行 |
[0, 12, 0](存在逾期) |
检查到第 2 项 12 时触发 break 跳出 |
不执行 |
[](空列表,无记录) |
列表为空,未触发 break,循环自然结束 |
执行 |
5.11.2 不要把循环 else 误解为“循环未执行”
初学者易受 if ... else 影响,误以为“只有循环一次未执行时才走 else”。上表第 1 行表明:当输入为 [0, 0, 0] 时,循环完整执行了 3 次,最终依然进入了 else。
可将循环下方的 else 理解为 no_break(若未触发 break):
- 循环中途触发了
break\rightarrow 提前终止,不执行else; - 循环中途未触发
break(遍历完全部元素、空列表执行 0 次或中途执行过continue) \rightarrow 自然结束,执行else。
提示(工程实践中的写法选择):循环
else是 Python 的特色语法。因在其他语言中较为少见,许多开发者仍倾向使用显式标志变量found = False,或在函数内部直接通过return返回查找结果(见核心内容 Part II 练习 2)。编写时可自主选择,但阅读他人代码时需理解其执行机制。
5.12 持续接收输入:哨兵值与交互式循环
在 5.8.2 节中,营业额预先存放在列表中。但在实际收银或财务录入时,数据通常由操作员逐笔键盘输入,录入前总笔数未知。
处理此类交互录入任务时,清晰的架构是将程序划分为两个独立阶段:
- 第一阶段(循环录入):使用
while循环持续接收输入,将合法金额逐笔.append()追加至列表; - 第二阶段(遍历汇总):录入结束退出
while循环后,使用for循环遍历列表进行总额与均值统计。
这种“先采集、后汇总”的两阶段结构将全部原始明细完整保存在列表中,便于后续扩展极值分析或对账核对。
在第一阶段中,程序如何识别录入完毕?通常约定一个正常业务中不可能出现的特殊数值作为终止信号。这类仅用于传递控制信号、本身不属于业务数据的特殊值称为哨兵值(Sentinel Value)。
由于营业额均为非负数(\ge 0),可约定:输入 -1 代表结束录入(哨兵值);输入其他负数视为非法输入提示重输;输入非负数追加至列表。
提示(输入格式假设):下方代码使用
float(input(...))将输入字符串转为浮点数,默认输入为合法数字字符。若输入非数字字符会引发ValueError,相关异常处理将在后续章节介绍。
sales_records = []

# 持续接收键盘输入:
#     若输入哨兵值 -1.0,立即跳出录入循环
#     若输入其他负数,提示重输并跳过本轮
#     若输入非负数,追加至列表 sales_records
while True:
    amount = float(input("请输入一天的销售额(-1 结束):"))

    if amount == -1.0:
        break
    if amount < 0.0:
        print("金额不能为负,请重新输入")
        continue

    sales_records.append(amount)

total_sales = 0.0
for amount in sales_records:
    total_sales += amount
record_count = len(sales_records)

print(f"已上报天数:{record_count} 天")
print(f"已上报销售额合计:{total_sales:.2f} 元")
假设操作员依次输入 120、-2、0、80 和 -1,交互过程如下:
请输入一天的销售额(-1 结束):120
请输入一天的销售额(-1 结束):-2
金额不能为负,请重新输入
请输入一天的销售额(-1 结束):0
请输入一天的销售额(-1 结束):80
请输入一天的销售额(-1 结束):-1
已上报天数:3 天
已上报销售额合计:200.00 元
该程序包含四处关键设计细节:
while True:与break配合:循环前无法预知输入内容,通过while True:启动无限循环,并在内部通过if amount == -1.0: break控制退出;- 两处
if判断顺序不可颠倒:必须先检查哨兵值-1.0,再检查非法负数< 0.0。因为-1.0本身亦满足< 0.0,若调换次序,输入-1时将被作为非法负数拦截触发continue,导致无法正常退出循环; - 哨兵值与非法数据不入列表:无论是终止信号
-1.0还是错误负数-2,均在.append()之前被拦截,保证列表中存储的均为有效营业额; - 哨兵值与 5.8.2 节缺失标记的区别:5.8.2 节中
-1.0存储于列表中作为漏报标记,故不能直接用len()计算均值;本节-1仅为控制信号未存入列表,列表长度len(sales_records)即为实际有效天数。
核心内容 Part II 练习
练习 1:列出满足利润要求的全部方案
沿用 5.9 节本量利参数:单位变动成本 30.0 元,固定成本 1000.0 元。候选单价列表为 [50.0, 60.0],候选销量列表为 [100, 200, 300],目标利润设为 3000.0 元。
请使用双层嵌套循环(外层遍历单价、内层遍历销量),打印出所有利润达到或超过 3000.0 元的方案明细,并在最后输出达标方案的总个数。
提示:本题要求列出全部达标方案(共 4 个),因此内层循环遇到首个达标销量时,不能使用 break 提前跳出。
练习 2:查找首笔超过审核门槛的订单
在内部审计中,常需从流水中筛查首笔超额大单。编写函数,接收非负订单金额列表 order_amounts 与非负审核门槛 threshold,返回列表中首笔严格超过(>)该门槛的订单编号(编号从 1 开始);若所有订单均未超标或传入空列表,返回 0。
要求使用 enumerate(..., start=1) 实现,并思考:为何在循环中遇到首笔超额订单即可直接执行 return?
订单金额列表 order_amounts |
审核门槛 threshold |
期望返回编号 | 业务场景说明 |
|---|---|---|---|
[500.0, 1000.0, 1200.0, 1500.0] |
1000.0 | 3 | 第 2 笔恰好等于 1000.0 不算超标,第 3 笔首次超标 |
[1200.0, 500.0] |
1000.0 | 1 | 第 1 笔即超标,立即返回 1 |
[500.0, 1000.0] |
1000.0 | 0 | 无严格大于 1000.0 的订单,遍历完毕后返回 0 |
[] |
1000.0 | 0 | 空列表无数据,循环不执行,直接返回 0 |
练习 3:逐日录入销售额并计算平均值
请在 5.12 节交互录入程序的基础上,在末尾补充计算已上报日期平均销售额的代码(输入均为合法数字字符,单位为元)。
业务规则保持不变:输入 -1 结束录入;输入其他负数提示“金额不能为负,请重新输入”;输入非负数存入列表。汇总阶段要求如下:
- 若至少录入了一笔有效销售额(如输入
120, -2, 0, 80, -1),打印已上报日期的平均销售额(保留两位小数); - 若未录入任何有效数据便直接输入
-1,程序不得执行除法,应打印提示:“没有有效记录,无法计算平均值”。
| 依次从键盘输入的数字序列 | 已上报天数 | 销售额合计 | 期望输出的平均销售额或提示 |
|---|---|---|---|
120, -2, 0, 80, -1 |
3 天 | 200.00 元 | 66.67 元 |
0, -1 |
1 天 | 0.00 元 | 0.00 元 |
-1 |
0 天 | 0.00 元 | 没有有效记录,无法计算平均值 |
参考答案与编程指引
练习 1:列出满足利润要求的全部方案
prices = [50.0, 60.0]
quantities = [100, 200, 300]
unit_cost = 30.0
fixed_cost = 1000.0
target_profit = 3000.0
plan_count = 0

for price in prices:
    for quantity in quantities:
        profit = (price - unit_cost) * quantity - fixed_cost
        if profit >= target_profit:
            plan_count += 1
            print(f"单价 {price:.2f} 元,销量 {quantity} 件,利润 {profit:.2f} 元")

print(f"达标方案:{plan_count} 个")
输出:
单价 50.00 元,销量 200 件,利润 3000.00 元
单价 50.00 元,销量 300 件,利润 5000.00 元
单价 60.00 元,销量 200 件,利润 5000.00 元
单价 60.00 元,销量 300 件,利润 8000.00 元
达标方案:4 个
编程指引:达标方案计数器 plan_count = 0 必须置于外层循环开始之前。若误写在两层循环之间,每切换一个单价计数器都会被清零,最终只能统计出最后一个单价(60.0 元)下的方案数(2 个)。
练习 2:查找首笔超过审核门槛的订单
def find_first_large_order(order_amounts: list, threshold: float) -> int:
    """返回首笔严格超过门槛的订单编号,未找到时返回 0。"""
    for order_no, amount in enumerate(order_amounts, start=1):
        if amount > threshold:
            return order_no
    return 0


print(find_first_large_order([500.0, 1000.0, 1200.0, 1500.0], 1000.0))
print(find_first_large_order([1200.0, 500.0], 1000.0))
print(find_first_large_order([500.0, 1000.0], 1000.0))
print(find_first_large_order([], 1000.0))
输出:
3
1
0
0
编程指引:该代码展示了函数内部顺序查找的紧凑范式。for 循环从首笔订单依次向后遍历,首次满足 amount > threshold 时的 order_no 必然是第一笔超标编号。此时直接在 if 分支内执行 return order_no,即可同时完成“返回结果”与“终止循环及函数”两项操作,无需额外定义标志变量或 break。若遍历完毕仍未触发 return,则执行末尾的 return 0。
练习 3:逐日录入销售额并计算平均值
sales_records = []

while True:
    amount = float(input("请输入一天的销售额(-1 结束):"))

    if amount == -1.0:
        break
    if amount < 0.0:
        print("金额不能为负,请重新输入")
        continue

    sales_records.append(amount)

total_sales = 0.0
for amount in sales_records:
    total_sales += amount
record_count = len(sales_records)

print(f"已上报天数:{record_count} 天")
print(f"已上报销售额合计:{total_sales:.2f} 元")

if record_count > 0:
    average_sales = total_sales / record_count
    print(f"已上报日期的平均销售额:{average_sales:.2f} 元")
else:
    print("没有有效记录,无法计算平均值")
当依次输入 120、-2、0、80 和 -1 时,输出结果为:
已上报天数:3 天
已上报销售额合计:200.00 元
已上报日期的平均销售额:66.67 元
编程指引:在第一阶段 while True 循环中,终止信号 -1 与误输负数 -2 均在 .append() 前被拦截,保证存入列表的均为有效营业额。在汇总阶段,列表长度 len(sales_records) 即为准确的有效上报天数。计算日均值前通过 if record_count > 0: 防御,安全处理未录入数据直接退出的边界情况。
本章回顾
综合本章内容,无论循环业务场景如何变化,其核心执行脉络均可归纳为三个阶段:循环前初始化状态变量,循环中按步推进状态变量,循环后输出或返回计算结果。
下表汇总了本章核心语法结构与典型应用场景:
| 业务需求与场景 | 推荐写法或结构 | 关键原理与防错提醒 |
|---|---|---|
| 创建空列表并逐笔追加数据 | 先写 items = [],再用 items.append(x) |
.append() 是原地修改,切勿写成 items = items.append(x) |
| 按位置读取列表中的某个元素 | items[0]、items[1] |
索引表示偏移量,从 0 开始编号,注意防止越界 |
| 将列表中的数据从头到尾处理一遍 | for item in items: |
循环变量直接接收元素本身,无需通过索引间接读取 |
| 按固定规律生成整数序列并重复 | for i in range(start, stop, step): |
左闭右开(含头不含尾);要包含终点整数 n,终点应写 n + 1 |
| 事先未知次数、达标才停止的任务 | while 条件表达式: |
循环体内必须包含状态更新语句,使变量逐步靠近终止条件 |
| 计算总额(累加)或统计笔数(计数) | 循环外初始化为 0,循环内逐步累加 |
切勿将初始化语句写进循环体内,否则每轮都会被重置为 0 |
| 仅对符合条件的数据进行处理 | 在循环体内嵌套 if 分支 |
注意缩进层级:缩进在 if 内部的语句才受条件控制 |
| 略过特殊或异常数据,继续下一轮 | 在循环体内使用 continue |
仅跳过本轮剩余语句;在 while 中切勿跳过步进更新语句 |
| 找到目标后提前结束当前层循环 | 在循环体内使用 break |
立即跳出当前最内层循环,外层循环继续正常执行 |
| 在函数中找到结果后立即返回并退出 | 在函数内部的循环中使用 return |
立即结束整个函数调用;若计算汇总值,return 必须放在循环外 |
| 遍历数据时同时获取序号与元素 | for no, item in enumerate(items, start=1): |
成对解包获取序号与元素,省去手动维护计数器的步骤 |
| 测算“价格 \times 销量”全组合 | 双层嵌套循环 | 外层走一步,内层转一轮;总执行次数等于两列表长度相乘 |
编写完循环代码后,建议重点检验以下五类边界情况:
- 空数据(空列表
[]、预算月数为0、直接输入哨兵值-1):程序是否会触发除零异常或索引越界? - 单条数据(
n = 1、列表中仅 1 笔订单):循环能否正常执行 1 轮并得出正确结果? - 临界值数据(金额恰好等于 99 元门槛、利润恰好等于目标值):
<与<=是否准确?range()终点是否遗漏边界项? - 全都不达标(目标利润过高,所有候选销量均不满足):标志变量或默认返回值能否正确反映“未找到”?
- 初始即达标(初始资金本身已大于目标金额):
while循环能否跳过循环体直接返回0?
补充说明(Tips)
提示 1:不要在 for 循环体内修改循环变量
在 Python 的 for 循环中,每轮迭代开始时,解释器会自动从可迭代对象中取出下一个元素重新赋给循环变量。因此,即使在循环体内修改循环变量(如 number = 999),下一轮迭代开始时循环变量仍会被序列中的下一元素覆盖。切勿尝试在 for 循环体内修改循环变量来调整步长或跳过元素;如需跨步取值,应直接设置 range(start, stop, step) 的步长参数。
此外,Python 的 for、while 和 if 缩进块不会创建独立的局部作用域。只要循环至少执行过一次,循环结束后循环变量在外部依然存在,并保留着最后一轮迭代所赋的值;但若遇到空序列、循环一次未执行,该变量则尚未被定义。因此,循环结束后仍需使用的变量(如 total、count、found),均应在循环前显式初始化。
最后,本章遍历列表的案例均为只读遍历。若在 for item in items: 遍历过程中直接删除列表元素,会导致后续元素整体前移、索引错位,引发漏算或异常。安全的动态修改方法将在后续列表章节中专门介绍。
提示 2:浮点数精度误差与财务金额口径
为了直观展示带小数的日常金额,本章部分案例使用了浮点数(float)。但在计算机底层,浮点数基于 IEEE 754 二进制浮点标准存储。正如十进制中 \frac{1}{3} 为无限循环小数,十进制中的 0.1 和 0.2 转为二进制也是无限循环小数,截断保存后导致 0.1 + 0.2 的实际结果为 0.30000000000000004。若在循环中对大量浮点数反复累加,尾数误差便可能逐步放大。
因此,涉及金额与小数循环时应遵循两条规范:
- 不使用浮点数的相等判断(
==或!=)作为while循环的终止条件。例如每次加0.1,若条件写作while x != 1.0:,可能因累加 10 次后的实际值为0.9999999999999999而不等于1.0,陷入无限循环; - 在对精度要求严格的金融与财务系统中,不宜直接用
float存储金额。稳妥做法是将金额乘以 100 转为以**整数“分”**为单位的int进行累加与比较,或使用 Python 标准库中的decimal.Decimal十进制高精度模块。
同时需注意,print(f"{average_cost:.2f}") 中的 :.2f 仅在输出显示时格式化为两位小数,并未改变内存中的数值精度。实务中“逐笔先舍入再汇总”与“精确原值汇总后再舍入”可能产生尾差,开发时需严格遵循会计制度或业务合同规定的舍入口径。
提示 3:何时手写累加循环,何时直接调用 sum()?
若仅需将列表 [1200.0, 1500.0, 1300.0] 中的全部数值直接相加,内置函数 sum() 一行代码即可完成:
daily_sales = [1200.0, 1500.0, 1300.0]
total_sales = sum(daily_sales)
print(f"销售额合计:{total_sales:.2f} 元")
输出:
销售额合计:4000.00 元
既然 sum() 如此简便,为何本章仍重点讲解手写累加循环?
原因在于 sum() 仅适用于“现有序列原样无条件相加”的简单场景。一旦面对带有业务规则的复杂任务——例如跳过 -1.0 漏报记录(5.8.2 节)、先根据单笔金额计算运费再汇总(5.8.3 节),或累加至预算上限时需提前 break 终止(核心内容 Part I 练习 3)——sum() 便无法直接胜任,必须通过手写循环控制每一步的条件筛选与状态更新。此外,理解累加器的状态演化也是学习算法与数据处理的基石。在日常开发中:单纯求和直接调用 sum();需结合筛选、计数、转换或提前跳出时,则编写清晰的循环结构。
章节导航:上一章:第四章 if 语句与分支结构